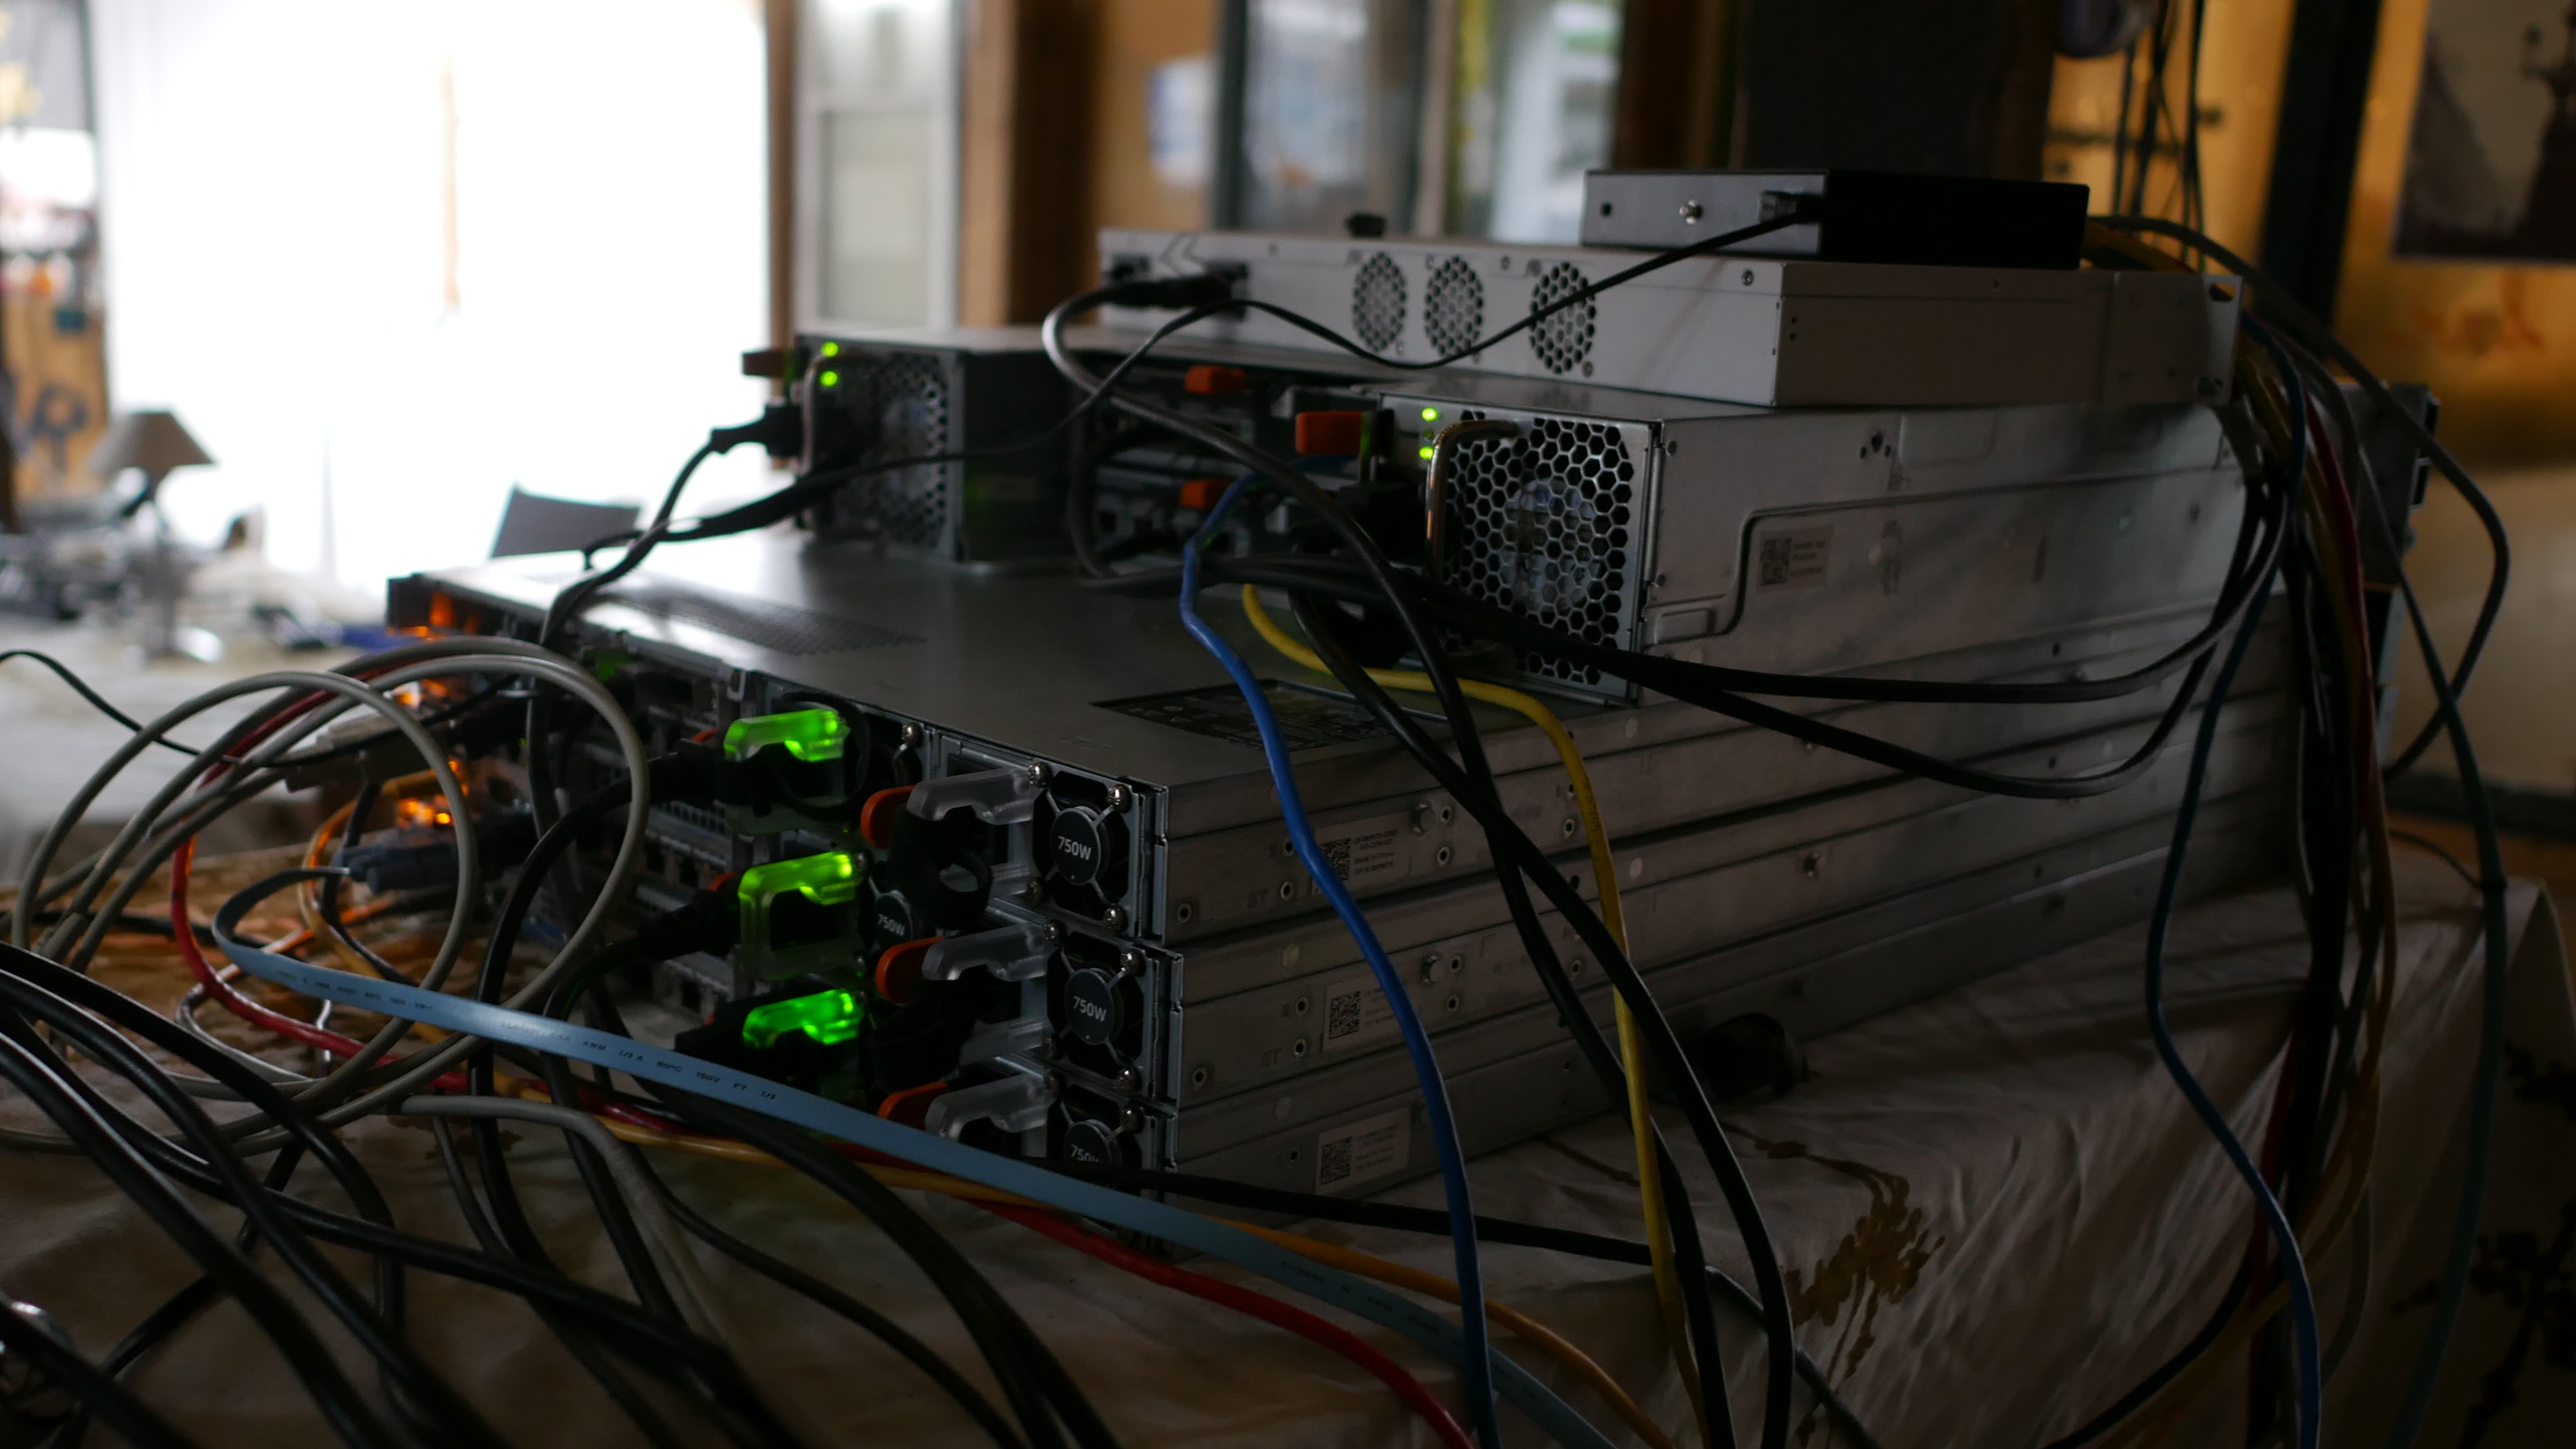
Ce samedi 3 octobre entre 21h30 et 23h30 (heure locale), nous avons rencontré un incident qui a impacté l'ensemble de nos lignes internet ainsi que notre serveur VPN. Un·e bénévole a dû se rendre au datacenter pour rétablir la situation, un grand merci !
Toutes nos excuses aux membres impacté·es.
La panne s'est produite suite à une mise à jour de l'un de nos serveurs en vue de préparer une maintenance prévue le lundi 5 octobre (remplacement des disques SSD, ajout de RAM, et ajout de cartes réseaux plus performantes).
Pour ce faire, nous avons mis ce serveur en maintenance, et Proxmox a automatiquement migré ses machines virtuelles vers nos deux autres serveurs. Malheureusement, l'un de ces serveurs a planté car il n'avait pas assez de mémoire vive pour accueillir ces nouvelles machines virtuelles.
Ne nous étant pas aperçu·es de ce crash, nous avons ensuite redémarré le serveur en maintenance comme prévu. Nous nous sommes donc retrouvé·es avec un seul serveur encore fonctionnel sur trois. Le cluster ayant perdu son quorum (la majorité des serveurs n'étant plus joignables), le service watchdog a redémarré ce dernier serveur par mesure de sécurité.
Nos serveurs étant tous chiffrés, lorsque ceux-ci redémarrent nous devons nous connecter à leur interface de gestion à distance (iDRAC) pour entrer la phrase de passe et débloquer le démarrage. Or, l'accès à ces interfaces passe par notre propre réseau, qui était lui aussi hors service. N'ayant plus aucun accès depuis l'extérieur, nous n'avons pas eu d'autre choix que d'intervenir sur place pour déchiffrer les disques.
Nous avons profité de cette intervention pour ajouter de la RAM à nos serveurs, ce qui nous permet désormais d'absorber la charge d'un serveur en maintenance, et installer des cartes réseaux plus performantes (Intel X710). Ces opérations étaient prévue le lundi 5 octobre et auraient nécessité de redémarrer nos serveurs.
Pour éviter ce genre de situation à l'avenir, nous réfléchissons à mettre en place un accès « out of band » (par ex. un accès via la 4G), nous permettant d'intervenir à distance même lorsque l'ensemble de notre cluster redémarre.
Chronologie
- 21h00 : mise en maintenance du serveur « topi », migration automatique des machines virtuelles vers les serveurs « nam » et « bour » par Proxmox
- 21h15 : crash de nam (manque de RAM)
- 21h30 : redémarrage de topi pour la mise à jour, perte du quorum, redémarrage automatique de bour par le watchdog, coupure totale du service
- 22h30 : arrivée au datacenter
- 22h45 : ajout de la RAM et des cartes réseaux
- 23h10 : redémarrage du cluster
- 23h30 : cluster opérationnel, sessions BGP rétablies, retour à la normale
